Claude Artık Yazdıklarını Damgalıyor
Araştırmacıların dikkat etmesi gerekenler: filigran nasıl çalışıyor, hangi metinlerde tutunuyor, neyi kanıtlıyor?
Son birkaç haftadır sosyal medyada YZ'nin tespitiyle ilgili sorular var: "Claude'a yazdırdığım metne gizli bir işaret mi koyuyorlar? Yarın dergi beni yakalar mı?" Sorunun kendisi meşru, ancak ilgide hemen "bunu şu araçla nasıl çözeriz" içerikleri var.
Anthropic 11 ve 14 Ağustos 2026'da konuyu iki ayrı resmî belgeyle açıkladı. Ben de kaynakları tek tek okudum ve akademik yazım pratiğimiz açısından ne anlama geldiğini derli toplu bir şekilde yazmak istedim. Gelin inceleyelim.
🔍 Claude şu an filigran ekliyor mu?
Kısa cevap: modele bağlı, ama yön belli.
2 Ağustos 2026 tarihinde ve sonrasında yayımlanan Claude modelleri işaretlemeyi (marking) doğuştan destekliyor. Bu tarihten önce çıkmış modellere destek eklenmesi çalışması sürüyor; Avrupa Birliği düzenlemesi bu eski modeller için 2 Aralık 2026'ya kadar bir geçiş süresi tanımış durumda. Yani "şimdilik güvendeyim" diye düşünülecek bir aralıktayız.
Kapsam da oldukça geniş. İşaretleme model düzeyinde uygulandığı için Claude'un web arayüzü, API, Claude Code, Claude Cowork dâhil desteklenen bütün araçlarda geçerli. Üstelik dünya genelinde. Anthropic bunu açıkça yazıyor: bölgeye göre kapsamı daraltmanın kalıcı bir yolu henüz olmadığı için filigran her yerde uygulanacak. Kullanıcının kapatabileceği bir seçenek de bulunmayacak.
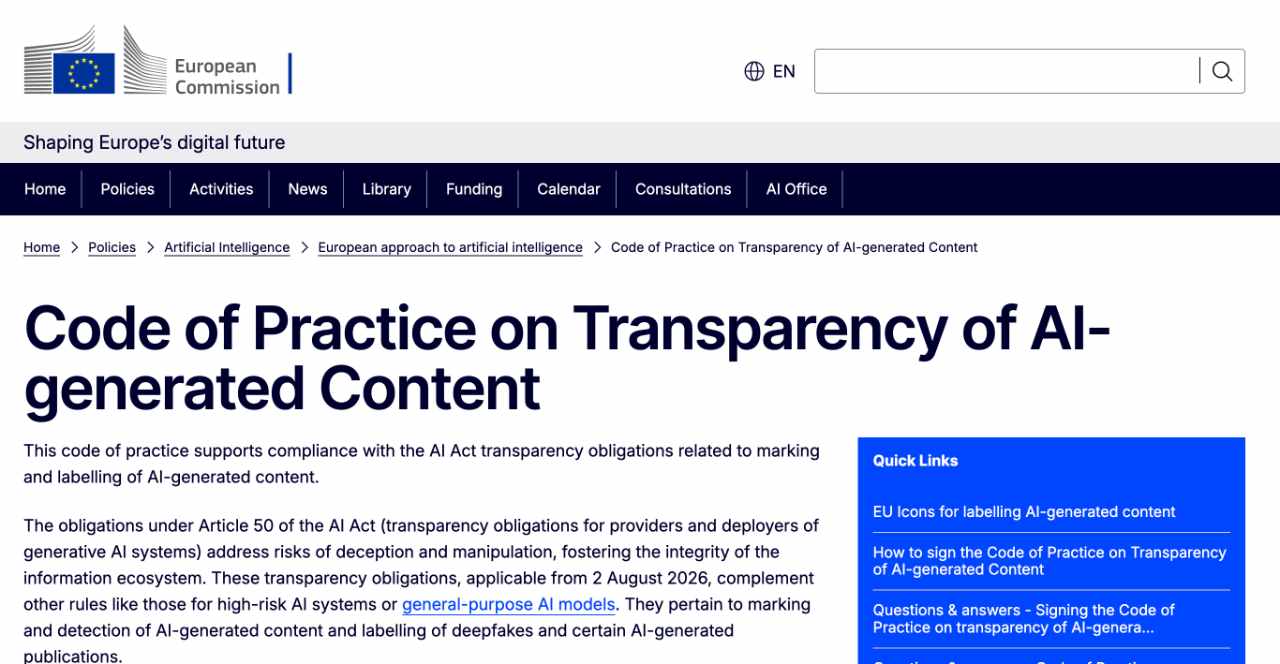
Gerekçe ise Avrupa Birliği Yapay Zekâ Yasası'nın (EU AI Act) 50. maddesindeki şeffaflık yükümlülükleri. Anthropic, yaklaşık 190 imzacıyla birlikte Temmuz 2026'da yapay zekâ üretimi içeriğin şeffaflığına dair uygulama kurallarını (Code of Practice on Transparency of AI-Generated Content) imzaladı. Burada altını çizmek isterim: Bu, Claude'a özgü bir uygulama değil. Aynı belgeyi OpenAI, Google, Meta ve Microsoft da imzaladı. Dolayısıyla "ben başka modele geçerim" cümlesi, en azından orta vadede, bir çözüm görünmüyor. Muhtemelen regüle olmayanlar da bunu iyi satacak gibi görünüyor.
⚙️ Bu filigran tam olarak nasıl çalışıyor?
İşte en çok yanlış anlaşılan kısım burası. Metne görünmez karakter, gizli kod veya özel işaret eklenmiyor. Anthropic'in kendi ifadesiyle: metne hiçbir şey eklenmiyor, gizli karakter yok, ek token gerekmiyor ve maliyeti değiştirmiyor. Yani metni bir düz metin düzenleyicisine yapıştırıp "acaba içinde bir şey var mı?" diye aramanın anlamı yok. Aranacak bir şey de yok.
Kullanılan yöntem istatistiksel kelime seçimi damgalaması (statistical token-level watermarking). Mantığı şöyle:
Dil modeli metni kelime kelime üretir. Her adımda önündeki aday kelimeler arasından birini seçer. "Hava bugün soğuk ve..." cümlesinde bir sonraki kelimenin "kapalı" mı yoksa "gri" mi olacağı okuyucu açısından hiçbir anlam farkı yaratmaz. Normalde bu seçim rastgele bir sayıyla çözülür. Filigranlama ise rastgeleliğin kaynağını değiştiriyor: rastgele sayı üreteci yerine gizli bir anahtar ve metinde hemen önce gelen birkaç kelime kullanılarak seçim yapılıyor.
Sonuçta kelimeler dışarıdan bakınca yine rastgele görünüyor. Ama anahtarı elinde bulunduran biri, kelime dizilimini kontrol ederek metnin Claude tarafından üretilmiş olma olasılığını hesaplayabiliyor.
Anthropic bunu Monopoly benzetmesiyle anlatıyor ve benzetme gerçekten yerinde: zar atmak yerine pi sayısının ondalık basamaklarından bir yerden başlayıp sırayla ilerleseniz, oyun oynayanlar açısından hiçbir şey değişmez, hamleler yine rastgeledir. Ama oyun bittikten sonra hamle dizisine bakan ve pi sayısını bilen biri, o oyunun pi ile oynandığını anlayabilir.
Metin de bu anlamda "damgalanmış" oluyor. Teknik olarak yöntem, Google DeepMind'ın 2024'te Nature'da yayımladığı SynthID-Text yaklaşımının bir versiyonu. Kökeni ise Scott Aaronson'ın 2022'deki önerisine dayanıyor. Yani ortada bir gecede uydurulmuş bir mekanizma değil, literatürü olan bir yöntem var.
Filigran hiçbir kimlik bilgisi taşımıyor. Ne filigranın kendisinde ne de anahtarında, kullanıcıya, kurumuna veya sohbet geçmişine dair bilgi geri kazandıracak bir unsur bulunuyor. "Bu metni hangi kullanıcı üretti" sorusu teknik olarak cevaplanamıyor. Cevaplanabilen tek soru şu: "Bu metnin üretiminde Claude'un payı var mı?"
Görsel ve dosya çıktıları farklı çalışıyor. Claude bir .png, .jpg veya .svg üretirse metin filigranı değil, C2PA açık standardına dayalı, kriptografik olarak imzalanmış bir üst veri (content credential) ekliyor. Dosyanın içeriği değişmiyor, sadece not düşülüyor; C2PA uyumlu herhangi bir araç bunu okuyabiliyor. Fotoğraf makinesi üreticilerinin ve fotoğraf düzenleme yazılımlarının yıllardır kullandığı bir standart bu aslında.
📊 Filigranın tutunduğu ve tutunmadığı yerler
Bu tablo bence en işlevsel kısım. Çünkü filigranın her metne aynı yoğunlukta yerleşmediğini bilmek, kaygıyı doğru yere yöneltmemizi sağlıyor.
| Kullanım biçimi | Filigran yoğunluğu | Akademik karşılığı |
|---|---|---|
| Uzun, sıfırdan üretilmiş metin | Yüksek — tespit görece güvenilir | Tam bölüm yazdırma |
| Kısa pasajlar (birkaç cümle) | Çok düşük — tespit güvenilmez | Tek paragraf desteği |
| Olgusal, tek doğru cevaplı ifadeler | Neredeyse yok | Tanım, formül, künye |
| Kod | Çok düşük (yalnızca yorum satırları) | Analiz betikleri |
| Yalnızca dilbilgisi/noktalama düzeltmesi | İhmal edilebilir | Redaksiyon |
| Claude'un yaptığı çeviri | Yüksek | Türkçe → İngilizce çeviri örneğin |
Çalışma mantığı basit: filigran, "iki seçenek de aynı derecede iyi" olduğu durumlarda çalışıyor. Nitekim Anthropic bunu şöyle örnekliyor: "Isaac Newton'ın en ünlü eseri Principia..." cümlesinde bir sonraki kelimenin "Mathematica" olması zorunludur, tek doğru cevap odur. Filigranın tutunacağı bir seçim alanı yoktur. Aynı sebeple kod da genellikle az filigran taşır; kodda çoğu zaman kesin çıktı gerekir, keyfî seçim alanı yalnızca yorum satırları gibi yerlerde kalır.
Redaksiyon tarafı da benzer. Kendi yazdığınız bir metni Claude'a verip "sadece dilbilgisini düzelt" derseniz, geri gelen metnin neredeyse tüm kelimeleri size aittir. Filigranın tutunacağı yer, sadece o birkaç düzeltmedir ki bu genellikle tespit için yeterli olmaz.
Ama çeviri tamamen başka bir hikâye. Şahsen bunun en kritik nokta olduğunu düşünüyorum ve muhtemelen çoğunluğun gözünden kaçacak. Çeviride her kelimeyi Claude seçer. Dolayısıyla Claude'a yaptırılan bir çeviri, tam yoğunlukta filigran taşır. Türkçe yazıp makaleyi Claude'a çeviren araştırmacılar, ki hiç de az değil, bu ayrımı bilmeli. Aslında, gelişmekte olan ve anadili İngilizce olmayan ülkelerin YZ ile olan çeviri avantajı bir nevi ellerinden alınmış olacak. Tabi, bu kadar çeviri programı varken, bir şekilde bu işten de yırtacağımızı düşünüyorum.
🧽 Filigranı kaldırmak mümkün mü?
Evet, mümkün. Anthropic bunu inkâr da etmiyor; dürüstlük adına not edilmeli.
Hafif düzenleme filigranı tamamen silmiyor. Her kelimenin değiştirildiği tam bir yeniden yazım ise, siliyor. Anthropic burada haklı bir soru soruyor: o noktada metnin hâlâ "yapay zekâ üretimi" sayılıp sayılamayacağı tartışmalıdır. Gerçekten de her cümleyi baştan kuran biri, artık ödünç aldığı fikri kendi diline tercüme etmiş sayılır.
Bunun dışında filigranı zayıflatan başka etkenler de var: Çok kısa pasajlar zaten yeterli sinyal taşımıyor; yeniden ifadelendirme (paraphrase) sinyali seyreltiyor; uygulama boru hatlarından ve biçimlendirme aşamalarından geçen metinlerde filigran kayboluyor. Dosya üst verisi ise çok daha kırılgan. Format dönüştürmek, ekran görüntüsü almak veya sıradan bir işleme adımı C2PA bilgisini silebiliyor.
Demem odur ki, filigran kurşun geçirmez bir mühür değil. Olasılıksal bir sinyal. Bunu böyle anlamak, hem gereksiz paniği hem de gereksiz rahatlığı önlüyor.
🏛️ Yayıncıların elinde anahtar var mı?
Şu an itibarıyla hayır. Kamuya açık bir tespit aracı henüz yayımlanmadı. Anthropic, yakında bir filigran tespit API'si sunacağını ve uygulama ayrıntılarının hâlâ üzerinde çalıştığını belirtiyor. Yani bugün hiçbir dergi, hiçbir editör, hiçbir kurum "Claude anahtarıyla" bir metni kontrol edemiyor.
Burada bir ayrımı netleştirelim, çünkü sıkça karıştırılıyor: Turnitin'in yapay zekâ modülü, Pangram ve benzeri tespit yazılımları tamamen farklı bir yöntem kullanıyor. Bu şirketlerde Anthropic'in anahtarı yok. Onlar metindeki üsluba, "izlerine" bakıyorlar. Yapay zekâ modellerinin belirli kalıplara olan düşkünlüğüne, tekrar eden cümle yapılarına, alışılmadık sıklıkta kullanılan kelimelere. Bu, filigran kontrolünden esas itibarıyla farklı bir işlem. Biri istatistiksel bir imzayı doğrular, diğeri üsluptan tahmin yürütüyor diyebiliriz.
Peki bugün yazılan bir metin yarın yakalanabilir mi? Dürüst cevap: evet, teknik olarak mümkün.
Filigran metnin kendisine gömülü olduğu ve kopyala-yapıştırla birlikte taşındığı için, bugün üretilip bir makaleye yerleştirilen uzun bir Claude metni, tespit API'si yayımlandıktan sonra geriye dönük olarak kontrol edilebilir. Metin zaten damgalı; eksik olan tek şey erişim. Erişim de takvime bağlı bir mesele.
⚠️ Asıl kritik nokta: filigran neyi kanıtlar?
Bu bölümü atlamayın, çünkü akademik camianın asıl bilmesi gereken şey burası ve muhtemelen önümüzdeki yılın tartışması da bunun üzerinden dönecek. Bir intihal/benzerlik tartışması gibi gidecek görünüyor.
Filigran yalnızca şunu söyler: "Claude bu içerikle bir noktada muhtemelen ilgilenmiş." Anthropic'in kendi ifadesiyle, filigran "Claude bunu yazdı" ile "Claude bunu ağır biçimde düzenledi" ayrımını yapamaz. Ayrıca telif veya yazarlık sahipliğini de değiştirmez.
Tersi de aynı derecede önemli: filigran bulunmaması, metnin insan ürünü olduğunu kanıtlamaz. Model filigranlama yayılmadan önce çıkmış olabilir, metin ağır biçimde düzenlenmiş olabilir, pasaj güvenilir bir şekilde tespit edilebilmesi için fazla kısa olabilir, üst veri format dönüşümünde silinmiş olabilir. Yani ne pozitif sonuç suçlama, ne de negatif sonuç aklanma anlamına gelir.
Nature'ın konuyla ilgili haber analizinde Carnegie Mellon'dan bilgisayar bilimci Nihar Shah'ın vurgusu tam da buraya oturuyor: yapay zekâ firmaları söz verdikleri doğrulama araçlarını gerçekten sunar ve bu araçların yanlış pozitif oranı kabul edilebilir düzeyde düşük olursa, bazı meşru olmayan kullanımlar tespit edilebilir. Şartlı bir cümle bu. İki koşul da henüz sağlanmış değil.
Dolayısıyla mesele "tespit mümkün mü" sorusu değil. Mesele şu: kurumlar, dergiler ve etik kurullar olasılıksal bir sinyali nasıl yorumlayacak? Bir olasılık skorunu kesin kanıt gibi okuyan bir kurul, masum bir araştırmacıyı hedef alabilir. Bu konuda akademinin yargıları nasıl şekillenecek, hepimiz göreceğiz.
🎯 Peki biz ne yapacağız?
Somutlaştıralım. Bu bilgilerin akademik pratiğimize dört yansıması var:
1. Filigran bir intihal kanıtı değildir; bunu savunun. Kurumsal politika tartışmalarında, etik kurul yönergelerinde ve dergi yazım kurallarında bu ayrımın altını çizmek bizim sorumluluğumuz. Olasılıksal bir sinyalin disiplin soruşturmasına dönüşmesi ciddi bir haksızlık doğurur.
2. Risk üretimde yoğunlaşır, düzeltmede değil. Kendi yazdığınız metni dil kontrolü için Claude'a vermek pratikte tespit edilebilir bir iz bırakmaz. Buna karşılık tam çeviri, tam filigran taşır. Bu ikisini aynı torbaya koymayın.
3. Şeffaf beyan en güvenli stratejidir. Elsevier, Springer Nature ve ICMJE gibi kurumlar zaten yapay zekâ kullanımının yöntem veya teşekkür bölümünde beyan edilmesini istiyor. Beyan edilmiş kullanım, olası bir filigran tespitini krizden çıkarıp rutin bir bilgiye dönüştürür. Ben kendi yazılarımda dil desteği aldığım yerleri açıkça belirtiyorum ve bunun şeffaflık olduğunu düşünüyorum.
4. Model değiştirmek çözüm değildir. Aynı taahhüdü imzalayan tüm büyük sağlayıcılar kendi filigranlarını uyguluyor. Bu bir firma politikası değil, yasal regülasyonlar.
Nihayetinde mesele teknik bir mesele gibi görünüyor, ama değil. Asıl mesele, yapay zekâyı yazım sürecimizin neresine yerleştirdiğimiz. Fikri kuran, kurguyu yapan, veriyi yorumlayan biz isek, aracın metne dokunmuş olması kimsenin uykusunu kaçırmamalı. Ama araç fikri de kuruyorsa, filigran olsun olmasın, orada konuşulması gereken başka bir şey vardır. Maalesef, ölçemediğimiz şeylerin yargısını yapmak boşa bir çaba.
Siz kendi yazım sürecinizde bu sınırı nereye çekiyorsunuz? Merak ediyorum.
📚 Kaynakça
- Anthropic. (2026, 14 Ağustos). How Claude's text watermark works. anthropic.com/news/claude-text-watermark
- Anthropic. (2026, 11 Ağustos). How Claude marks AI-generated content [Yardım merkezi belgesi]. support.claude.com
- Dathathri, S., See, A., Ghaisas, S., Huang, P.-S., McAdam, R., Welbl, J., … Kohli, P. (2024). Scalable watermarking for identifying large language model outputs. Nature, 634(8035), 818–823. doi.org/10.1038/s41586-024-08025-4
- Nature (2026). Can Anthropic's invisible watermarks curb 'AI slop'? Researchers remain sceptical. doi.org/10.1038/d41586-026-02503-7
- Avrupa Komisyonu. (2026, Temmuz). Strong backing for the Code of Practice on Transparency of AI-generated Content. digital-strategy.ec.europa.eu